پیشبینی کیفیت محصول، زمان خرابی تجهیز یا مصرف انرژی با داده صنعتی ممکن است؛ اما یک خطای کوچک در تعریف مسئله میتواند مدلی با نمودارهای زیبا و تصمیمهای ضعیف بسازد. تفاوت اصلی محیط صنعتی با یک مجموعهداده آموزشی در زمان، علت و هزینه خطاست: نتیجه آزمایشگاه دیر ثبت میشود، شرایط خوراک تغییر میکند و خرابی واقعی به ندرت رخ میدهد. بنابراین پرسش حرفهای «دقت مدل چند درصد است؟» نیست؛ پرسش این است که در چه شرایطی، چند ساعت زودتر، با چه عدم قطعیتی و برای کدام تصمیم پیشبینی میکنیم.
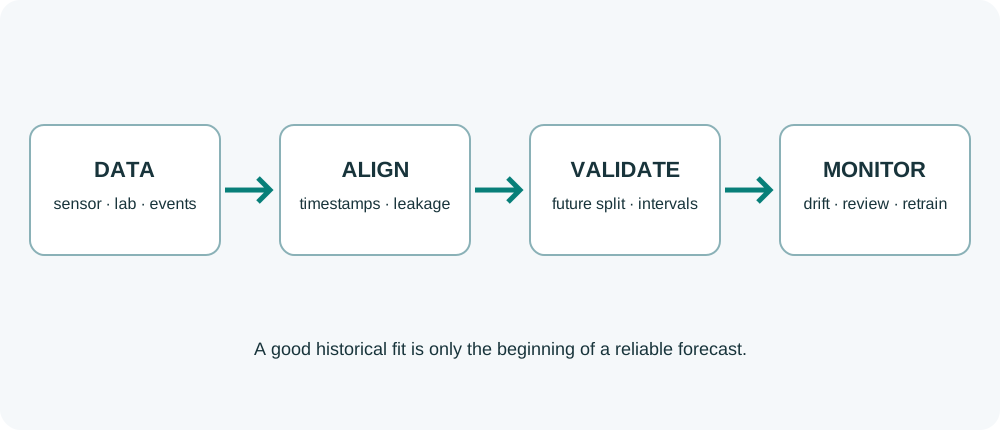
مسئله را به شکل قابل آزمون بنویسیم
فرض کنید میخواهیم درصد رطوبت خروجی یک خشککن را دو ساعت پیش از آزمایش پیشبینی کنیم. باید زمان تصمیم، افق پیشبینی، واحد اندازهگیری، دامنه مجاز خطا و اقدامی را که اپراتور میتواند انجام دهد مشخص کنیم. اگر آزمایشگاه تنها هر چهار ساعت نمونه میگیرد، «پیشبینی دقیقهبهدقیقه» با همان برچسبها ادعای بزرگی است. برای خرابی نیز باید معلوم باشد رخداد موردنظر توقف کامل، افت عملکرد یا تعویض برنامهریزیشده قطعه است.
یک تعریف عملی میتواند چنین باشد: «با داده موجود تا ساعت ۱۰، احتمال خروج کیفیت ساعت ۱۲ از محدوده مجاز را برآورد کن؛ فقط وقتی هشدار بده که هزینه هشدار کاذب از هزینه عدم هشدار کمتر باشد.» این تعریف، نوع برچسب، پنجره زمانی و معیار ارزیابی را روشن میکند.
پنج مانع واقعی در داده صنعتی
۱. ناهمزمانی و تأخیر. حسگر هر ثانیه مقدار میفرستد؛ آزمایشگاه چند ساعت بعد عدد ثبت میکند؛ سیستم تعمیرات تاریخ رخداد را دستی وارد میکند. اتصال رکوردها با زمان ثبت به جای زمان وقوع میتواند رابطهای ساختگی بسازد. باید ساعت دستگاهها، تأخیر نمونهبرداری و زمان در دسترس شدن هر متغیر ثبت شود.
۲. نشت اطلاعات از آینده. اگر برای پیشبینی ساعت ۱۲ از میانگین کل شیفت، نتیجه آزمایش ساعت ۱۳ یا کد تعمیر پس از خرابی استفاده کنیم، آزمون آفلاین بسیار خوب میشود ولی مدل در عمل آن اطلاعات را ندارد. هر ویژگی باید با پرسش «آیا در لحظه تصمیم واقعاً موجود بود؟» بازبینی شود.
۳. تغییر رژیم عملیاتی. خوراک، محصول، فصل، شیفت، حسگر، کنترلگر یا روش آزمایش عوض میشود. رابطه دما و کیفیت در رژیم جدید ممکن است همان رابطه قبلی نباشد. NIST نیز بر نمایندگی داده از شرایط واقعی و رخدادهای نادر تأکید میکند؛ داده بیشتر بهتنهایی کافی نیست [۱].
۴. کمبود نمونه شکست. در نگهداری پیشبینانه، خرابیهای واقعی کم و گاه بعد از تعویض قطعه سانسور میشوند. یک مدل که همیشه «خرابی ندارد» میگوید ممکن است accuracy بالایی داشته باشد. معیار بهتر میتواند نرخ کشف رخداد، هشدار کاذب در هر ماه، زمان پیشآگاهی و هزینه تصمیم باشد.
۵. متغیرهای پنهان و مداخله انسان. اپراتور پس از شنیدن صدای غیرعادی سرعت خط را کم میکند. مدل ممکن است سرعت کم را «علت خرابی» بیاموزد، در حالی که واکنش به نشانه خرابی بوده است. تفکیک همبستگی از علت، به دانش فرایند و ثبت اقدامات انسانی نیاز دارد.
اعتبارسنجی که به محیط واقعی شباهت دارد
تقسیم تصادفی سطرها معمولاً برای سری زمانی صنعتی نامناسب است: نمونههای یک بچ یا ساعات مجاور به دو طرف تقسیم میرسند. داده را بر اساس زمان و گاهی تجهیز یا سایت جدا کنید؛ مدل روی گذشته آموزش ببیند و روی بازه آیندهای که هرگز ندیده آزموده شود. فاصله حفاظتی میان آموزش و آزمون بگذارید اگر پنجره ویژگیها یا برچسبها همپوشانی دارند. عملکرد را به تفکیک شیفت، نوع خوراک، دستگاه و شرایط پرت گزارش کنید.
| پرسش ارزیابی | معیار مناسب | خطای رایج |
|---|---|---|
| پیشبینی مقدار کیفیت | MAE و خطا به تفکیک رژیم | گزارش فقط R² کل |
| هشدار خرابی | recall رخداد، هشدار کاذب در ماه، lead time | اتکا به accuracy |
| تصمیم زیر عدم قطعیت | پوشش بازه پیشبینی و هزینه عملیاتی | نمایش تنها یک عدد |
| پایداری در زمان | افت عملکرد ماهانه و سهم داده خارج از دامنه | آزمون یکباره |
یک baseline ساده، مثل آخرین مقدار معتبر یا مدل خطی، لازم است. اگر مدل پیچیده از آن بهتر نشود، پیچیدگی بیشتری توجیه ندارد. همچنین بازه پیشبینی باید بررسی شود: «رطوبت ۷٫۲٪ با بازه ۶٫۵ تا ۸٫۱٪» برای تصمیم مرزی اطلاعات بیشتری از عدد تنها دارد. بازهای که در ۹۰٪ موارد ادعای پوشش دارد باید نزدیک به همان نرخ روی داده آینده پوشش بدهد.
آنچه هوش مصنوعی هنوز حل نکرده است
مدل نمیتواند از حسگری که وجود ندارد متغیر فیزیکی را با قطعیت بازسازی کند؛ نمیتواند خرابی دیدهنشده را با تضمین شناسایی کند؛ و بدون ثبت مداخلهها نمیتواند اثر علّی یک تنظیم جدید را اثبات کند. مدلهای بنیادین و یادگیری عمیق میتوانند نمایش داده را بهتر کنند، اما محدودیت اندازهگیری و تغییر شرایط را حذف نمیکنند. نقشه راه ۲۰۲۶ NIST برای تولید هوشمند نیز مدیریت داده، یکپارچهسازی حسگر و کنترل، توضیحپذیری و قابلیت اعتماد را همچنان موانع اصلی میداند [۲].
فرصت پژوهشی و مسیر اجرای کمریسک
فرصت اصلی در ترکیب مدل آماری با دانش فیزیکی و بازخورد بهرهبرداری است: ویژگیهای مرتبط با موازنه جرم و انرژی، مدلهای ترکیبی فیزیک و داده، تخمین عدم قطعیت، تشخیص تغییر رژیم و نمونهبرداری هوشمند از آزمایشگاه. برای شروع، یک خط و یک خروجی مشخص انتخاب کنید؛ کیفیت زمانمهرها را ممیزی کنید؛ baseline بسازید؛ آزمون زمانی انجام دهید؛ چند هفته مدل را در حالت سایه بدون دخالت در کنترل اجرا کنید؛ سپس اثر هشدارها را با اپراتور بسنجید. پایش افت عملکرد و امکان بازگشت به روش قبلی باید بخشی از طرح استقرار باشد.
در مسئلهای که پیشبینی باید به انتخاب تنظیمات منجر شود، مقاله چالش بهینهسازی پیچیده صنعتی گام بعدی را توضیح میدهد. برای پایش تجهیزات نیز راهنمای نگهداری پیشبینانه را بخوانید.
منابع
۱. NIST، How to Find the Right Balance of Data for Your Industrial AI System، ۲۰۲۵.
۲. Vogl و همکاران، 2026 Roadmap on Artificial Intelligence and Machine Learning for Smart Manufacturing، NIST، ۲۰۲۶.
۳. NIST، Challenges to the Monitoring of Deployed AI Systems، ۲۰۲۶.
پرسشهای متداول
چرا مدلی که روی داده تاریخی دقیق است در کارخانه خطا میکند؟
ممکن است داده آموزش آینده را لو داده باشد، شرایط عملیاتی عوض شده باشد، حسگر تغییر کرده باشد یا نمونههای نادر در آموزش حضور نداشته باشند. آزمون زمانی و پایش پس از استقرار ضروری است.
برای پیشبینی خرابی به چه دادهای نیاز داریم؟
علاوه بر سیگنال حسگر، زمان دقیق تعمیرات، توقفها، حالت بهرهبرداری، تعویض قطعه و تعریف روشن خرابی لازم است. بدون این زمینه، برچسب خرابی اغلب قابل اعتماد نیست.