مدل Jev محصول TypeSafe AI برای پاسخهای ساختاریافته است: یک «وضعیت» و چند پرسش مشخص میگیرد و به جای نوشتن متن آزاد، انتخاب، امتیاز یا احتمال بله/خیر برمیگرداند [۱]. این ویژگی برای مسیریابی پروندهها و تشخیص اینکه کدام رکورد نیاز به بررسی دارد جذاب است. اما اگر مسئله «پیشبینی دقیق عیار نمونه فردا» یا «بهینهسازی دمای کوره» باشد، Jev به تنهایی مدل مناسب آن محاسبه نیست. کاربرد صنعتی درست آن، افزودن لایه قضاوت محدود و قابل ارزیابی کنار مدلهای عددی، قواعد سخت و متخصص حوزه است.
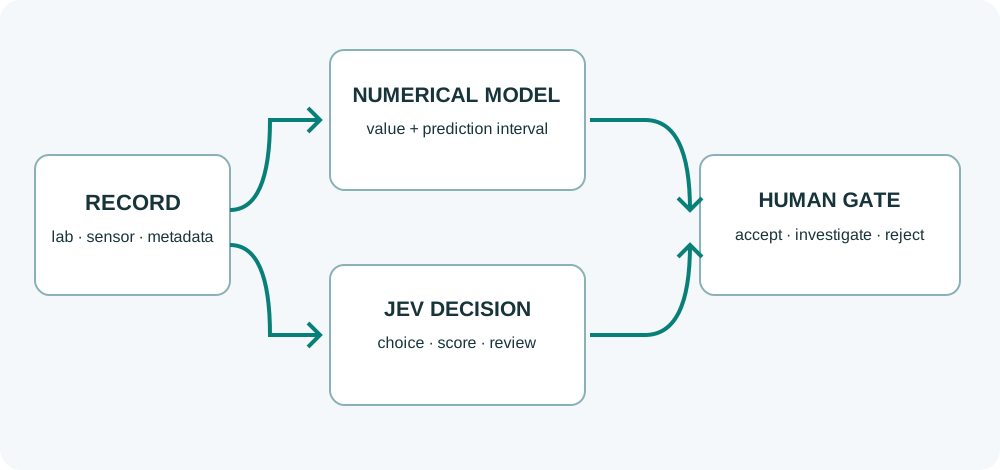
Jev دقیقاً چه خروجی میدهد؟
در مستندات رسمی، پرسش Choice یکی از گزینههای از پیش تعریفشده را با توزیع احتمال انتخاب میکند؛ Score رکورد را روی یک مقیاس رتبهای میسنجد؛ و Noul احتمال درست بودن یک گزاره را بین صفر و یک میدهد [۱]. چند پرسش میتوانند روی یک وضعیت در یک درخواست بررسی شوند، اما پاسخ هر پرسش مستقل است. بنابراین بهتر است پرسشهای مرکب را خرد کنیم و منطق ترکیب را در کد نگه داریم.
| نیاز در آزمایشگاه یا صنعت | روش مناسب | نمونه خروجی |
|---|---|---|
| تشخیص نوع اشکال گزارش | Jev Choice با گزینههای روشن | «مشکل واحد»، «نمونه نامعتبر»، «نیاز به کارشناس» |
| اولویت بازبینی | Jev Score، پس از آزمون محلی | امتیاز ریسک در مقیاس تعریفشده |
| تشخیص وجود شاهد کافی | Jev Noul | احتمال بله/خیر |
| پیشبینی عیار، بازده یا دمای آینده | مدل رگرسیون یا مدل فیزیکی | عدد و بازه عدم قطعیت |
| محاسبه موازنه جرم یا اعمال حد ایمنی | کد قطعی و قاعده مهندسی | نتیجه قابل تکرار و قابل ممیزی |
این جداسازی مهم است. یک امتیاز «ریسک بالا» به معنای پیشبینی مقدار فیزیکی دقیق نیست. همچنین عدد احتمال خروجی را نباید بدون آزمایش کالیبراسیون محلی، معادل احتمال واقعی خرابی در خط خاص خودمان دانست.
مثال ۱: کنترل کیفیت داده آزمایشگاه
فرض کنید رکورد آزمایش شامل شناسه نمونه، روش آزمون، واحد، مقدار، حد تشخیص، تاریخ نمونهبرداری و یادداشت کارشناس است. پیش از Jev، قواعد قطعی باید مواردی مانند واحد نامعتبر، مقدار خارج از دامنه فیزیکی و شناسه تکراری را بررسی کنند. سپس میتوان از Jev پرسید «آیا یادداشت آزاد کارشناس به آلودگی نمونه اشاره میکند؟» یا «کدام یک از سه علت تعریفشده برای بازبینی محتملتر است؟». اگر خروجی مبهم باشد، پرونده به کارشناس برمیگردد. عدد نهایی غلظت را دستگاه و روش محاسبه آزمایشگاهی تعیین میکنند، نه قضاوت زبانی مدل.
برای مدلسازی علمی، این لایه میتواند کیفیت ورودی را بهتر کند: رکوردهای مشکوک جدا شوند، رابطه میان نمونه و استاندارد مرجع قبل از محاسبه بررسی شود و دلیل انتخاب در لاگ بماند. پژوهش Jev for Scientific Decisions نیز Jev را برای انتخاب روابط معنایی آمادهشده پیش از محاسبه قطعی ارزیابی کرده است؛ مطالعه نشان میدهد حتی انتخاب اشتباه یک رابطه میتواند شمارش پاییندستی را عوض کند، گاهی بدون آنکه برچسب نهایی عوض شود [۲]. این یافته دلیل خوبی است که تنها «درستی پاسخ نهایی» را معیار آزمون نگذاریم.
مثال ۲: پیشبینی کیفیت در کارخانه
برای پیشبینی کیفیت محصول، مدل زمانی یا فیزیکی روی داده حسگر و آزمایشگاه مقدار و بازه پیشبینی تولید میکند. Jev میتواند پس از آن یک تصمیم محدود بگیرد: آیا گزارش اپراتور با تغییر رژیم خوراک سازگار است؟ آیا رکورد برای بررسی متخصص اولویت دارد؟ کدام علت از میان گزینههای تعریفشده برای افت کیفیت به شواهد متنی نزدیکتر است؟ خروجی Jev نباید مستقیم به فرمان کنترل تبدیل شود. قیود ایمنی، محدوده تجهیز و تأیید عملیاتی باید در لایه جداگانه اعمال شوند.
این کاربرد، یک طرح پیشنهادی است؛ شواهد منتشرشده درباره دقت Jev روی داده صنعتی خاص این سایت نداریم. بدون داده برچسبخورده محلی نمیتوان ادعای بهبود دقت، سرعت یا هزینه برای خط شما کرد. محدودیتهای پیشبینی داده صنعتی توضیح میدهد چرا حتی بخش عددی این معماری به اعتبارسنجی زمانی نیاز دارد.
چگونه Jev را منصفانه ارزیابی کنیم؟
نخست، مجموعهای از رکوردهای واقعی با تنوع شیفت، تجهیز، روش آزمایش و حالتهای مبهم بسازید. برچسب مرجع را دستکم یک متخصص حوزه تعیین کند و موارد اختلاف را ثبت کنید. سپس Jev را با قواعد ساده و یک روش موجود مقایسه کنید. معیار فقط درصد پاسخ درست نیست: خطای هر کلاس، کیفیت احتمالها، نرخ ارجاع به انسان، هزینه خطای پرخطر، زمان پاسخ و تغییر عملکرد در دورههای جدید را جداگانه گزارش کنید.
آستانه عمل باید از هزینه تصمیم بیاید. اگر ارسال اشتباه یک نمونه به بازبینی فقط چند دقیقه هزینه دارد، آستانه میتواند متفاوت از تصمیمی باشد که محصول را رد یا تجهیز را متوقف میکند. برای حالت دوم، قاعده قطعی و تأیید انسانی لازم است. نسخه مدل، متن پرسش، گزینهها، داده ورودی مجاز و نتیجه نهایی باید ثبت شوند تا خطا قابل بازسازی باشد.
محدودیتهای باز و فرصتهای پژوهشی
Jev متن آزاد نمینویسد و جایگزین مدل سری زمانی، حلکننده بهینهسازی یا محاسبه فیزیکی نیست [۱]. گزینههای بدتعریفشده میتوانند خروجی ظاهراً مرتب اما غلط بدهند. احتمالهای ارائهشده نیز برای کاربرد تازه نیاز به آزمون کالیبراسیون دارند. داده آزمایشگاهی ممکن است محرمانه یا دارای شناسه حساس باشد؛ پیش از استفاده از سرویس بیرونی، سیاست داده و قرارداد دسترسی باید بررسی شود.
فرصت اصلی در ترکیب قضاوت معنایی با محاسبه قابل ممیزی است: Jev روابط یا اولویت بازبینی را پیشنهاد میکند، کد محاسبه را انجام میدهد، مدل عددی آینده را تخمین میزند و متخصص موارد پرریسک را تأیید میکند. اگر این معماری روی داده واقعی و با معیارهای پیشثبتشده آزموده شود، میتوان درباره ارزش آن در یک آزمایشگاه یا کارخانه مشخص قضاوت کرد؛ پیش از آن فقط یک فرضیه مهندسی است.
منابع
۱. TypeSafe AI، مستندات رسمی Jev و پرسشهای Choice، Score و Noul.
۲. Deng و همکاران، Jev for Scientific Decisions: Evaluating Semantic Choices and Their Consequences، نسخه ۴، اکتبر ۲۰۲۶.
۳. NIST، 2026 Roadmap on Artificial Intelligence and Machine Learning for Smart Manufacturing، زمینه کاربرد و موانع AI صنعتی.
پرسشهای متداول
آیا Jev میتواند دما یا کیفیت محصول را به صورت عدد پیوسته پیشبینی کند؟
Jev برای پاسخ به پرسشهای محدود از نوع انتخاب، امتیاز یا احتمال بله/خیر طراحی شده است. پیشبینی عدد فیزیکی پیوسته و محاسبه دقیق باید با مدل عددی یا کد مناسب انجام شود.
آیا احتمال خروجی Jev برای تصمیم ایمنی کافی است؟
خیر. باید آن را روی داده همان سایت کالیبره و آزمون کرد، خطا و هزینه تصمیم را سنجید و برای موارد مبهم یا پرخطر مسیر بازبینی انسانی داشت.